aa
```
## 正则表达式标志
| 标志 | 描述 |
| :---: | -------------------------------------------------- |
| g | 全局搜索 |
| i | 不区分大小写搜索 |
| m | 多行搜索 |
| y | 执行“粘性”搜索,匹配从目标字符串的当前位置开始 |
| u | Unicode模式。用来正确处理大于 \uFFFF 的Unicode字符 |
**`m`**
使用`m`标志时,会改变开始(`^`)和结束字符(`$`)的工作模式,变为在多行上匹配,分别匹配每一行的开始和结束,即`\n`或`\r` 分割。
**`y`**
使用`y`标志时,匹配是从`RegExp.lastIndex`指定的位置开始匹配,匹配为真时,会修改 `lastIndex`的值到当前匹配字符串后的位置,下次匹配从这个位置开始匹配,如果匹配为假时,不会修改`lastIndex`的值。
```js
let reg = /o/y
let str = 'foo'
// lastIndex 为 0,从字符 f 开始匹配
reg.test(str) // false
// 由于结果为 false, lastIndex 还是为 0
reg.test(str) // false
let str2 = 'oof'
// lastIndex 为 0 ,从字符 o 开始匹配
reg.test(str2) // true
// lastIndex 此时修改为 1, 从第二个 o 开始匹配
reg.test(str2) // true
// lastIndex 此时修改为 2
reg.test(str2) // false 此时开始匹配的字符是 f
// lastIndex没有被修改
reg.test(str2) // false
```
## 正则表达式中的捕获—— \1,\2,\3... 以及 $1,$2,$3
在上文中我们介绍了 `(x)` 是匹配 `x` 并捕获,那么有了捕获就必然可以去使用捕获到的结果, `\1,\2,\3...` 以及`$1,$2,$3...` 便是指捕获的结果。
`\1, \2, \3, \4, \5, \6, \7, \8, \9` 在正则表达式中使用,捕获结果为正则表达式的源模式.
在这个正则表达式中`(bc)`被捕获并标记为`\1`, `(ef)`被捕获并标记为`\2`。
```js
let reg = /a(bc)d(ef)/
```
也可以使用来简化正则表达式
```js
let reg = /a(bc)dbc/
let reg2 = /a(bc)d\1/
let str = 'abcdbc'
reg.test(str) // true
reg2.test(str) // true
```
`$1, $2, $3, $4, $5, $6, $7, $8, $9` 是`RegExp`的包含括号子表达式的正则表达式静态的只读属性。
```js
let reg = /a(bc)d/
let str = 'abcd'
reg.test(str)
console.log(RegExp.$1) // bc
```
在 `String.replace()` 中使用:
```js
let reg = /(\w+)\s(\w+)/
let str = 'apple pear'
str.replace(reg, '$2 $1') // pear apple
RegExp.$1 // apple
RegExp.$2 // pear
```
---
---
url: /article/ecdgrife/index.md
---
# 浅谈前端低代码
前端低代码在最近的这两年,不少的公司或技术团队都对此青睐有佳,并各自实现了各自的低代码平台。
## 前言
前端低代码,是指 无需代码或者仅需少量的代码,即可生成可交互的应用。
这个概念的兴起,期望于能够更快的去构建、部署新的应用,并降低门槛,让非技术开发人员也能够构建新的应用。
## 为什么做低代码
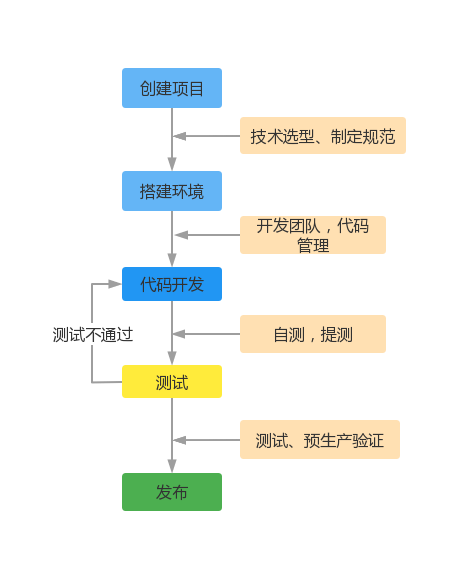
传统的应用开发从启动到发布的过程,大致的流程如下:
::: center
:::
在这个过程中,我们需要花费大量的时间用于 代码开发 -> 测试 这个过程,在这个过程,还需要根据项目大小,组织多个开发人员、测试人员等参与到项目中,包括制定开发规范、测试规范等。
而对于某些场景的应用,可能整个应用的生命周期相对较短,多个应用之间存在着类似的功能、需求、设计等等,然而在传统的项目开发中,
我们仍然需要按照上述的流程,完整的走一遍,才能正式发布上线,这无疑会花费大量的时间。一般我们会通过抽离重复的功能、需求、UI等为
独立的库、组件等,在新项目中实现复用,从而减少开发时间,然而这并不能对项目的发布速度有质的提升。
而对于一些小型企业,或者个体经营户,期望做一个线上应用,但并没有多余的资金资源去组建一个开发团队,对购买服务器、上线应用等更是一知半解,成为了制约他们发展的一道坎。
对于这些场景、存在的问题,需要需要一种方案,能够实现快速的实现从创建项目到发布部署为可访问的项目,并且能够面向更广泛的用户群体。
这成为了一个非常具有市场潜力的需求。
## 如何做低代码
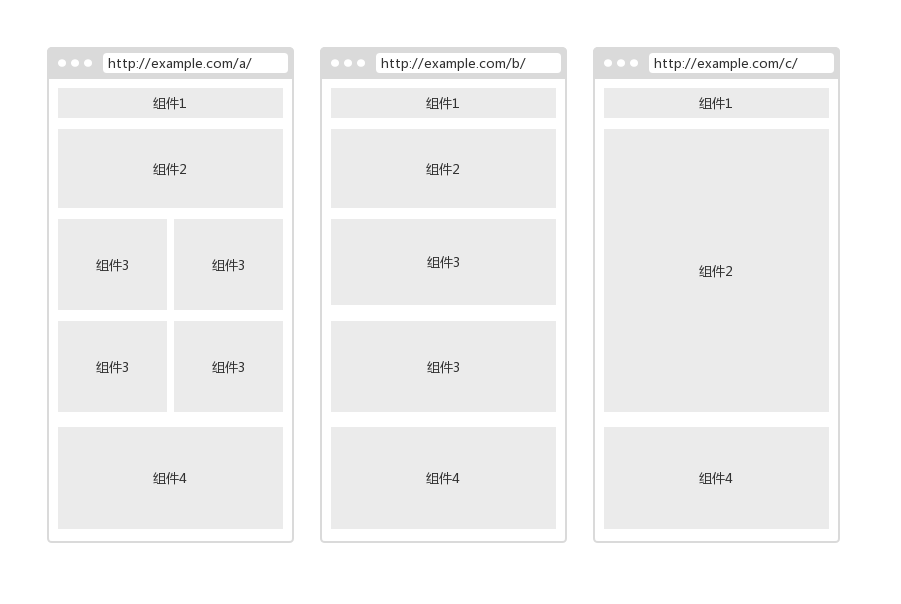
对于一个前端应用,通常由多个页面组成,在现代前端开发中,我们将页面拆分为一个个组件来进行组合:
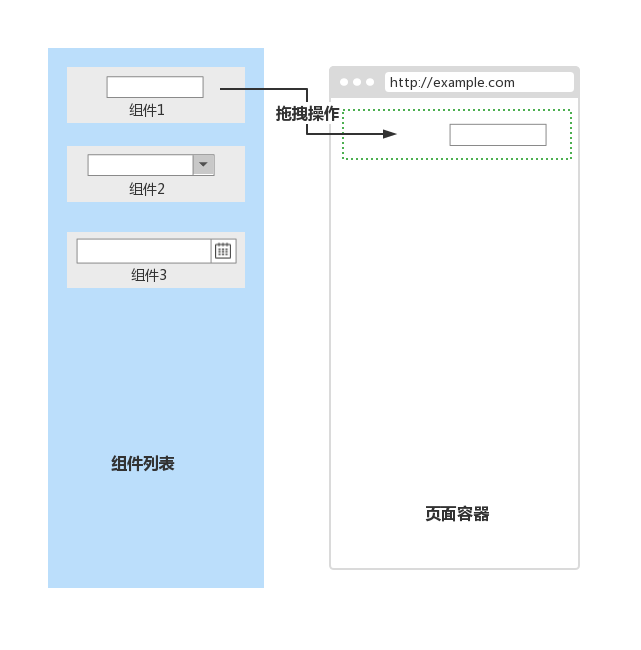
在 前端低代码 中,我们同样的,可以通过 组件来组装页面,通过可视化的交互方式,将组件拖拽到 页面容器中,
这种交互方式相对来说更加适用于更多的群体。
同时,需要提供能够对组件进行编辑状态的能力,以支持应用的个性化配置。
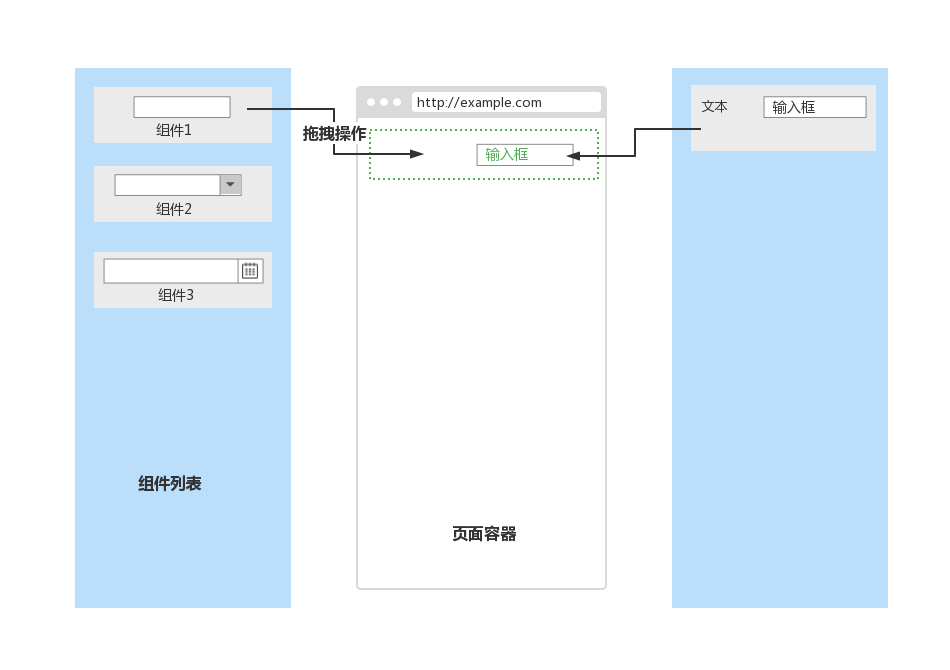
在初步确定好 基础的功能、交互方式后,就可以围绕它们,来完善 实现低代码平台的技术方案。
***
初步明确的,我们需要 通过 **组件** 来组装 应用,围绕这一块,需要实现:
* 低代码组件的规范:开发规范、接入规范;
* 用于承载组件、组装组件并渲染的应用容器;
* 组件的状态的更新与保存;
---
---
url: /article/exports-esm-and-cjs/index.md
---
# 单仓库实现同时导出esm、cjs
在开发一些公共模块作为一个独立仓库时,有时候可能会在一个使用 es 的项目中通过 `import` 导入,
有可能在一个 cjs 项目中通过 `require` 导入。
如何实现单个仓库能够同时被 cjs 和 esm 项目导入呢?
## 为什么这么做?
在过去的时间里,JavaScript 并没有一套标准的模块化系统,并且在过去的时间里,逐渐发展出了各种模块化解决方案,
其中最主流的有两种模块化方案:
* `CommonJs`: 即`cjs`,通过 `require('package')` 导入,`module.exports` 导出。
这套模块化系统应用与在`NodeJs` 和 `NPM packages`。
```js
// in cjs
const _ = require('lodash')
console.log(`assignIn: `, _.assignIn({ b: '2' }, { a: '1' }))
// { a: '1', b: '2' }
```
* `Ecmascript modules`: 即`esm`,在2015年,`esm` 最终确定为标准模块化系统,浏览器以及各个社区开始逐渐
迁移并支持`esm`。
```js
import { assignIn } from 'lodash'
console.log(`assignIn: `, assignIn({ b: '2' }, { a: '1' }))
// { a: '1', b: '2' }
```
`ESM`使用 `named exports`,能够更好的支持静态分析,对各种打包工具有利于做`tree-shaking`,
而且浏览器原生支持,作为一个标准,代表的是JavaScript的未来。
同时,在`NodeJs` 的 `v12.22.0`、`v14.17.0`版本,开始实验性的支持`ESM`,并在`16.0.0`版本开始正式支持`ESM`。
::: note
* ESM - [ECMAScrip modules](https://nodejs.org/api/esm.html)
* CJS - [CommonJs](https://nodejs.org/api/modules.html#modules-commonjs-modules)
:::
目前有很多包仅支持 `CJS` 或者 `ESM` 格式。 但同时,也有越来越多的包推荐并仅支持导出 `ESM` 格式。
但是相对来说,就目前而言,作为一个库,仅支持`ESM` 格式还是过于激进了。即使在 `NodeJs v16`已开始正式支持`ESM`,
但是整个社区的迁移还是需要大量的时间成本和人力成本的,如果某个版本破坏性的从`CJS`支持迁移到`ESM`,
那么可能导致一系列问题。
所以,如果一个库,能够同时支持`ESM`以及`CJS`,是一种相对来说更为安全的迁移方案。
## 共存问题
我们知道,`Nodejs` 能够很好的同时支持 `ESM` 和 `CJS` 进行工作,但是,有一个最主要的问题是,不能在一个 `CJS` 中
导入`ESM`,这时候会抛出一个错误:
```js
// cjs package
const pkg = require('esm-only-package')
```
```txt
Error [ERR_REQUIRE_ESM]: require() of ES Module esm-only-package not supported.
```
因为`ESM` 模块本质上是一个异步模块,所以不能用 `require()` 方法同步的导入一个异步的模块。
但是这并不意味着完全不能在 `CJS` 模块中使用`ESM` 模块,我们可以使用 动态 `import()` 的方式,来异步的导入`ESM` 模块。
`import()` 会返回一个 `Promise`:
```js
// CJS
const { default: pkg } = await import('esm-only-package')
```
但是,这并不是一个令人满意的解决方案,它与我们日常使用的模块导入方式来说,显得有点笨拙,不符合一般使用习惯,
我们还是更期望能够符合一般习惯的导入方式:
```js
import cjs from 'cjs-package'
// ESM
import { named } from 'esm-package'
```
## 如何做?
### package.json
在现在的稳定版本的`NodeJs` 中,已经支持同时在一个包中导出两种不同的格式。
在`package.json` 文件中,有一个`exports` 字段,提供给我们有条件的导出不同格式。
```json
{
"name": "package",
"exports": {
".": {
"require": "./index.js",
"import": "./index.mjs"
}
}
}
```
这一段声明描述了, 当进行导入包的默认模块时,如果是通过 `require('package')` 进行导入,那么引入的是 `./index.js` 文件,如果是通过`import pkg from 'package'`进行导入,那么引入的是 `./index.mjs` 文件。
`Nodejs` 会根据当前运行环境,选择合适的导入方式将包进行导入。
所以我们可以借助这一特性,来完成我们单仓库支持两个格式的第一步。
然后,下一个要解决的,就是如何构建两个格式的导出文件。
### Building
我们当然不可能为了同时支持`CJS`和 `ESM`,而编写两份代码。
但我们可以借助一些构建打包工具,来生成`ESM`和`CJS`代码。
通常情况下,我们可能会使用 `rollup` 来构建打包我们的模块。
或者也可以使用 `tsup` 来构建。
#### rollup
当我们会选择 `rollup` 来构建一个库时,可能配置如下:
```js
// rollup.config.js
export default {
input: 'src/index.js',
output: {
file: './dist/index.js',
},
}
```
由于`rollup` 是支持多配置打包的,所以我们可以使用多配置的方式,同时打包输出两种格式的文件:
```js
// rollup.config.js
export default [
{
input: 'src/index.js',
output: {
file: './dist/index.js',
format: 'cjs',
},
},
{
input: 'src/index.js',
output: {
file: './dist/index.mjs',
format: 'es',
},
},
]
```
#### tsup
`tsup` 是一个面向 `TypeScript` 的打包工具,基于 `esbuild`, 可以很方便的将我们的库打包成多种模式进行输出:
`tsup` 可以支持零配置,直接使用命令行即可输出两种格式
```sh
tsup src/index.ts --format esm,cjs
```
执行完成后,将会得到两个文件:`cjs` 格式文件`dist/index.js` 和 `esm`格式文件`dist/index.mjs` 。
使用构建工具构建完成后,接下来就是完善 `package.json`,
建议在使用 `type` 字段声明为 `module`, 来声明当前库时一个标准的 esm 库,以及添加 `main`,`module`,`exports`字段,
以便向下兼容:
```json
{
"name": "my-package",
"type": "module",
"main": "./dist/index.js",
"module": "./dist/index.mjs",
"exports": {
".": {
"require": "./dist/index.js",
"import": "./dist/index.mjs"
}
},
"types": "./dist/index.d.ts",
"files": ["dist"]
}
```
最后,你的 `CJS` 项目中,或者 `ESM` 项目中,均可以根据环境要求,导入这个包。
```js
// cjs
const pkg = require('my-package')
```
```js
// esm
import pkg from 'my-package'
```
## 总结
虽然 `Nodejs` 从 `v14.18.0` 版本开始稳定支持 `esm` ,并且到 `v16` 版本,正式支持 `esm`。
但将库升级到仅支持`esm` 还是一个比较激进的做法,建议从相对安全的 双格式支持 开始迁移,在合适的时机,过渡到仅支持`esm`。
---
---
url: /article/extends-prototype/index.md
---
# 继承与原型链
当谈到继承时,javascript只有一种结构:对象。
每个实例对象(object)都有一个私有属性`__proto__`指向它的构造函数的原型对象 **prototype**。
该原型对象也有自己的原型对象`__proto__`,层层向上,直到有一个的原型对象为null。根据定义,null没有原型,并作为这个原型链的最后一个环节。
几乎所有javascript中的对象,都是位于原型链顶端的`Object`的实例。
## 基于原型链的继承
### 继承属性
`javascript` 对象是动态的属性"包裹"(指自身的属性)。同时,对象还有一个指向一个原型对象的链。
当访问一个对象的属性时,不仅会在该对象上查找,也会在该对象的原型上查找,进而在该对象的原型的原型上查找,
依次层层向上查找,直到找到匹配的属性,或者到达原型链的末尾。
::: info ECMAScript标准
`obj.[[Prototype]]`符号用于指向`obj`的原型。从`ES6`开始`[[Prototype]]`
可以通过`Object.getPrototypeof()`和 `Object.setPrototypeof()` 访问器进行访问。
等同于许多浏览器实现的属性`__proto__`。
:::
从代码示例来分析继承属性:
在这个示例中,定义了一个函数`Foo`, 它拥有自身属性 `a`和`b`。
然后创建一个 `Foo` 的示例 `foo`。
```js
function Foo() {
this.a = 1
this.b = 2
}
let foo = new Foo()
Foo.prototype.c = 3
Foo.prototype.d = 4
// 输出自身的所有属性
console.log(foo) // { a: 1, b: 2 }
// 自身拥有属性 a
console.log(foo.a) // 1
// 自身拥有属性 b
console.log(foo.b) // 2
// 自身没有属性 c, 但其原型上有属性 c
console.log(foo.c) // 3
// 自身没有属性 d,但其原型上有属性 d
console.log(foo.d) // 4
```
在这个示例中, 整个原型链如下
```js
// { a: 1, b: 2 } => { c: 3, d: 4 } => Object.prototype => null
```
### 继承方法
在`Javascript` 中,并没有其他基于类的语言所定义的 方法。
任何函数都可以添加到对象上做为对象的属性。
函数属性的继承与其他属性的继承没有差别。
当继承的函数被调用时,`this`指向的是当前继承的对象,而不是继承的函数所在的原型对象。
```js
let o = {
a: 1,
f() {
return this.a + 1
},
}
// 此时 函数f 中的 this 指向了 o
console.log(o.f()) // 2
let p = Object.create(0)
p.a = 3
// p从o上继承了函数f, 此时函数f中的 this 指向了 p
console.log(p.f()) // 4
```
## 创建对象和生成原型链
### 使用语法结构创建的对象
```js
let o = { a: 1 }
// 原型链: o => Object.prototype => null
let arr = ['a', 'b']
// 原型链: arr => Array.prototype => Object.prototype => null
function f() {}
// 原型链: f => Function.prototype => Object.prototype => null
```
### 使用构造器创建对象
```js
function Person() {
this.a = 1
}
Person.prototype = {
f() {
return this.a
},
}
let p = new Person()
// 原型链: p => Person.prototype => Object.prototype => null
```
### 使用`Object.create`创建的对象
```js
let a = { a: 1 }
let b = Object.create(a)
// 原型链 b => a => Object.prototype => null
let c = Object.create(null)
// 原型链 c => null
```
## 扩展原型链的方法
### 构造器创建对象,原型赋值给另一个构造函数原型
```js
function Foo() {}
foo.prototype = {
a: 'foo',
}
function Bar() {}
let proto = new Foo()
proto.b = 'bar'
Bar.prototype = proto
let p = new Bar()
console.log(p.a) // foo
console.log(p.b) // bar
```
### Object.create
```js
function Foo() {}
Foo.prototype = {
a: 'foo',
}
function Bar() {}
let proto = Object.create(Foo.prototype)
proto.b = 'bar'
Bar.prototype = proto
let p = new Bar()
console.log(p.a) // foo
console.log(p.b) // bar
```
```js
function Foo() {}
Foo.prototype = {
a: 'foo',
}
function Bar() {}
let proto = Object.create(Foo.prototype, { b: 'bar' })
Bar.prototype = proto
let p = new Bar()
console.log(p.a) // foo
console.log(p.b) // bar
```
---
---
url: /article/fc6faley/index.md
---
在人工智能快速发展的今天,我们与 AI 的交互方式正在发生根本性变化。其中,**Prompt Engineering**(提示工程)作为一门新兴的技能,正成为解锁 AI 潜力的关键所在。
## 什么是 Prompt Engineering?
**Prompt Engineering** 指的是设计、优化和完善输入给 AI 模型的提示(prompt),以获得更准确、相关和有用输出的系统性方法。简单来说,就是**学会如何更好地向 AI 提问**。
这不仅仅是简单的"提问",而是包含了:
* 理解 AI 模型的工作原理
* 设计清晰、具体的指令
* 提供适当的上下文和约束条件
* 通过迭代优化获得最佳结果
## 为什么 Prompt Engineering 如此重要?
### 1. 质量差距巨大
同样的 AI 模型,不同的提示会产生天壤之别的结果:
```bash
# 普通提示
"写一个函数"
# 工程化提示
"请用 JavaScript 编写一个函数,接收数字数组作为参数,返回去重后的新数组。要求:
1. 不使用 Set 对象
2. 时间复杂度为 O(n)
3. 包含详细的 JSDoc 注释
4. 提供使用示例"
```
### 2. 成本效益显著
精心设计的提示可以减少:
* 重复请求次数
* 结果修正时间
* 总体计算资源消耗
### 3. 专业化需求增长
随着 AI 在各行业的深入应用,专业的 Prompt Engineering 技能成为:
* 开发者的核心竞争力
* 产品经理的必备技能
* 内容创作者的效率工具
## Prompt Engineering 的核心原则
### 1. 明确性 (Clarity)
**模糊提示:**
```bash
"帮我处理数据"
```
**明确提示:**
```bash
"请分析以下销售数据,计算:
- 每个产品的月销售额
- 同比增长率
- 生成前5名产品的排名
数据格式:CSV
输出要求:Markdown 表格"
```
### 2. 上下文提供 (Context Provision)
**缺乏上下文:**
```bash
"优化这段代码"
```
**提供充分上下文:**
```bash
"这是 React 组件中的性能优化问题:
- 组件在每次渲染时都重新计算大量数据
- 用户列表包含 1000+ 项
- 需要避免不必要的重渲染
请提供具体的 useMemo 和 useCallback 优化方案"
```
### 3. 约束条件 (Constraints)
**无约束:**
```bash
"写一篇技术文章"
```
**有约束:**
```bash
"以初级前端开发者为目标读者,写一篇关于 React Hooks 的入门文章:
- 字数:1500字左右
- 包含 useState 和 useEffect 的实用示例
- 避免使用复杂术语
- 采用友好的教学语气"
```
### 4. 示例引导 (Example-driven)
**零样本提示:**
```bash
"分类这些文本"
```
**少样本提示:**
```bash
"根据以下示例进行分类:
示例1:
文本:"这个产品太棒了,我非常喜欢!"
情感:积极
示例2:
文本:"服务质量很差,不会再来了"
情感:消极
现在请分类:
文本:"还行,一般般"
情感:"
```
## 实际应用场景
### 前端开发中的 Prompt Engineering
#### 代码生成与优化
```bash
# 工程化提示示例
"作为资深前端专家,请优化以下 React 组件:
问题描述:
1. 组件渲染性能低下
2. 事件处理函数每次渲染都重新创建
3. 缺乏必要的错误边界
优化要求:
- 使用 React.memo 避免不必要渲染
- 合理使用 useCallback 和 useMemo
- 添加 PropTypes 类型检查
- 实现简单的错误处理
请提供优化后的完整代码,并解释每个优化的原因。"
```
#### 技术方案设计
```bash
# 架构设计提示
"项目背景:需要为电商平台设计前端架构
技术要求:
- 使用 Next.js 13+ 和 TypeScript
- 支持服务端渲染和静态生成
- 状态管理使用 Zustand
- 样式方案采用 Tailwind CSS
- 需要良好的 SEO 支持
请提供:
1. 项目目录结构建议
2. 核心模块划分方案
3. 性能优化策略
4. 推荐的开发工具和流程"
```
## 进阶技巧与策略
### 1. 链式思考 (Chain-of-Thought)
引导 AI 展示推理过程:
```bash
"请分步骤解决这个问题:
问题:一个列表包含 [2, 7, 11, 15],目标值是 9,找出和为目标值的两个数。
第一步:理解问题要求...
第二步:考虑可能的解法...
第三步:实施最优方案...
第四步:验证结果..."
```
### 2. 角色扮演 (Role-playing)
为 AI 分配特定角色:
```bash
"假设你是谷歌的首席前端架构师,正在评审一个大型项目的代码质量。请以专业、严谨但建设性的语气,分析以下代码并提出改进建议:"
```
### 3. 模板化提示
创建可复用的提示模板:
```javascript
function codeReviewPrompt(code, requirements) {
return `
代码审查请求:
代码内容:
${code}
审查要求:
${requirements}
请从以下角度审查:
1. 代码质量和可读性
2. 性能考虑
3. 安全性问题
4. 最佳实践遵循情况
5. 具体的改进建议
`
}
```
## 常见陷阱与避免方法
### 1. 提示过于宽泛
**问题:** "帮我写代码"
**解决:** 提供具体的需求、约束和上下文
### 2. 缺乏具体示例
**问题:** "生成一些数据"
**解决:** 提供期望的输出格式和样本
### 3. 忽略模型限制
**问题:** 要求超出模型能力范围的任务
**解决:** 了解模型的特长和局限,合理设定期望
### 4. 单次尝试心态
**问题:** 期望第一次提示就获得完美结果
**解决:** 采用迭代优化,基于结果调整提示
## 工具与资源推荐
### 1. 提示优化工具
* **OpenAI Playground**:实验和优化提示
* **[PromptPerfect](https://promptperfect.jina.ai/)**:自动提示优化
* **AI Prompt Generator**:生成专业提示
### 2. 学习资源
* **OpenAI 提示工程指南**:官方最佳实践
* **Prompt Engineering Institute**:专业课程和案例
* **[Awesome Prompt Engineering](https://github.com/promptslab/Awesome-Prompt-Engineering)**:GitHub 上的资源集合
### 3. 实践平台
* **ChatGPT**:日常练习
* **Claude**:不同的提示风格测试
* **Midjourney**:视觉领域的提示工程
## 未来展望
Prompt Engineering 正在从"技巧"发展为"学科":
1. **标准化**:行业标准和工作流的建立
2. **工具化**:专门的提示设计和测试工具
3. **集成化**:与开发流程的深度集成
4. **专业化**:针对不同领域的专业提示模式
## 总结
Prompt Engineering 不是简单的"提问技巧",而是**系统性的沟通方法论**。它结合了:
* **技术理解**:了解 AI 的工作原理
* **沟通艺术**:清晰表达需求的能力
* **批判思维**:分析和优化结果的眼界
* **创意表达**:激发 AI 创造力的方法
掌握 Prompt Engineering 意味着:
* 更高效的开发工作流
* 更优质的技术产出
* 在 AI 时代保持竞争力
**记住:最好的提示工程师不是那些知道所有命令的人,而是那些最理解如何与智能系统有效协作的人。**
***
*进一步学习建议:尝试在下一个项目中应用这些原则,记录不同提示的效果差异,建立自己的提示库和经验总结。*
---
---
url: /article/fe5ruia1/index.md
---
# CSS 媒体查询
开发响应式网站时,常常需要使用到 media 媒体查询。这里总结下媒体查询的使用方法。
## 概述
媒体查询是通过判断当前媒体是否满足 媒体查询规则,从而使其包含的 CSS规则生效。
从 CSS level 2 开始,就已经支持 `media-queries`,到 CSS level 3 以及之后的版本,媒体查询变得更加的丰富和能够适应更多的场景。
## 使用
媒体查询可以通过以下三种方式进行使用:
### 在 `
` 元素引入CSS资源时,声明 `media` 属性
```html
```
### 在`
```
### 在`@import` 后 声明 媒体查询条件
```css
@import url('custom.css') screen and (min-width: 400px);
```
### 在样式表中使用 At-Rule `@media` 使用媒体查询规则
```css
@media screen and (min-width: 400px) {
.example {
color: red;
}
}
```
## 语法
```html
```
## 媒体查询 \[media-queries-list]
`media-queries-list` 可以由以下三种内容组成:
* `Media types` :媒体类型, 表示设备
* `Media features` :媒体特性, 表示设备的状态
* `Logical operators` : 逻辑操作符, 连接多个 `media-query`
### Media types
`Media types` 描述设备的一般类型。可以使用以下值:
* `all`: 表示适用于所有设备。 默认值。
* `print`: 表示 适用于在屏幕上以打印预览的模式查看页面和文档。
* `screen`: 表示 适用于屏幕 。
> 在 *css2.1* 和 *Media Queries 3* 中还支持 `tty`,`tv`,`projection`,`handheld`,`braille`,`embossed`,`aural`,但这些值都已经在*Media Queries 4* 中被弃用。
### Media features
媒体特性,描述 用户代理、输出设备以及环境的特定特征。
媒体特性表达式是完全是可选的,并且负责测试这些特性是否存在,值为多少。 且每个媒体特性表达式都必须使用括号括起来。
*以下仅列出比较常用到的媒体特性:*
* `width`: 视窗(viewport)的宽度,包括纵向滚动条的宽度。
值的类型为 number,单位可以是 `px`、`em` 等。
```css
with: 400px;
```
* `height`: 视窗(viewport)的高度。
值的类型为 number,单位可以是 `px`、`em` 等。
```css
height: 600px;
```
* `aspect-ratio`: 视窗(viewport)的宽高比。
值的类型为 number/number。
```css
aspect-ratio: 3/2;
```
* `orientation`: 视窗(viewport) 的旋转方向。
* portrait: 设备竖屏
* landscape: 设备横屏
```css
orientation: landscape;
```
* `resolution`: 输出设备的分辨率
值的类型为 number,单位为 `dpi`。
```css
resolution: 320dpi;
```
* `scan`:输出设备的扫描过程(适用于电视机等)。
#### 媒体特性前缀
大部分的媒体特性均支持前缀,用于约束媒体特性的作用范围。
* `max-[media feature]`: 小于指定的最大值时,返回*true*
* `min-[media feature]`: 大于指定的最小值时,返回*true*
*个人认为使用前缀时其表述稍显拗口,建议使用取值范围的方式声明表达式:*
#### 媒体特性语法
* 以键值对的形式,表述取固定的值
```txt
([media-feature-name]: [media-feature-value])
```
* 直接书写name, 表示值的结果为 boolean
```txt
([media-feature-name])
```
* 表述 特性的取值范围
*声明 range 为描述数学符号 : '<' | '>' | '<=' | '>='*
```txt
([media-feature-name] [range] [media-feature-value])
([media-feature-name] [range] [media-feature-value] [range] [media-feature-value])
```
### Logical operators
逻辑操作符用于组成复合的 media queries。
* `and`: 用于合并多条`media query`, 且 每条 `media query` 均返回 *true* 时,
媒体查询表达式的结果返回*true*。
* `not`: 取反操作,使用`not [media query]`,当`media query` 返回 *false* 时,
媒体查询表达式的结果返回*true*。
* `,`: or操作符,组合多个 `media query`,任意一个`media query` 返回 *true*,
媒体查询表达式的结果返回*true*。
* `only`: 不支持更加高级的媒体类型的浏览器检测到only修饰的时候就会抛弃这个规则
## 使用示例详解
### 示例1
```css
@media screen and (width > 414px) {
}
```
当设备的屏幕视窗宽度大于414px时,应用CSS块中的样式规则。
### 示例2
```css
@media (width > 800px), screen and (orientation: landscape) {
}
```
当前设备 视窗宽度大于 800px, 或者设备方向为横向时,应用css块中的样式规则。
### 示例3
```css
@media screen and (414px < width < 800px) {
}
```
当前设备屏幕视窗宽度 大于 414px 且 小于 800px 时, 应用css块中的样式规则。
---
---
url: /article/fpcpgpod/index.md
---
# JavaScript 进阶 一:词法作用域
在JavaScript的世界中,**词法作用域**是一个既基础又核心的概念,它决定了变量的可访问范围和生命周期。理解词法作用域不仅有助于写出更健壮的代码,更是掌握闭包、模块化等高级特性的前提。
## 什么是作用域?
作用域可以理解为**变量的可见范围和生命周期**。JavaScript中有三种主要的作用域类型:
### 1. 全局作用域
```javascript
// 全局变量,在任何地方都可以访问
const globalVar = '我在全局作用域'
function testGlobal() {
console.log(globalVar) // 可以访问
}
testGlobal()
console.log(globalVar) // 可以访问
```
:::warning 全局作用域的陷阱
过度使用全局变量会导致**命名冲突**和**变量污染**,应尽量避免。
:::
### 2. 函数作用域
```javascript
function outerFunction() {
const outerVar = '我在外部函数作用域'
function innerFunction() {
const innerVar = '我在内部函数作用域'
console.log(outerVar) // 可以访问外部变量
}
innerFunction()
// console.log(innerVar); // 错误:无法访问内部变量
}
outerFunction()
```
### 3. 块级作用域(ES6+)
```javascript
{
let blockVar = '我在块级作用域'
const constVar = '我也是块级作用域'
console.log(blockVar) // 可以访问
}
// console.log(blockVar); // 错误:无法访问块级变量
```
## 什么是词法作用域?
**词法作用域**(Lexical Scope)也称为静态作用域,指的是**变量在代码书写阶段就已经确定的作用域**,而不是在运行时确定。
:::info 关键理解
词法作用域由**代码书写的位置**决定,与函数调用位置无关。
:::
### 词法作用域示例
```javascript
const globalName = '全局变量'
function outer() {
const outerName = '外部函数变量'
function inner() {
console.log(outerName) // 可以访问外部变量
console.log(globalName) // 可以访问全局变量
}
return inner
}
const innerFunc = outer()
innerFunc() // 输出:"外部函数变量" 和 "全局变量"
```
在这个例子中,`inner`函数在定义时就确定了它能访问哪些变量,这就是词法作用域的体现。
## 作用域链的运作机制
当访问一个变量时,JavaScript引擎会沿着**作用域链**逐级查找:
:::steps
* **第一步**:在当前作用域查找变量
* **第二步**:如果没找到,向上一级作用域查找
* **第三步**:重复第二步,直到全局作用域
* **第四步**:如果全局作用域也没找到,抛出ReferenceError
:::
### 作用域链示例
```javascript
const globalNum = 10
function level1() {
const num1 = 20
function level2() {
const num2 = 30
function level3() {
console.log(globalNum) // 10
console.log(num1) // 20
console.log(num2) // 30
}
level3()
}
level2()
}
level1()
```
作用域链关系:
```txt
level3 → level2 → level1 → 全局作用域
```
## 词法作用域 vs 动态作用域
为了更好地理解词法作用域,让我们对比一下动态作用域:
```javascript
const name = '全局名称'
function showName() {
console.log(name)
}
function wrapper() {
const name = '局部名称'
showName() // 输出什么?
}
wrapper()
```
:::tip 思考题
在词法作用域下输出"全局名称",在动态作用域下会输出"局部名称"。
JavaScript采用**词法作用域**,所以这里输出"全局名称"。
:::
## 变量查找:LHS vs RHS
理解变量查找的两种方式有助于调试作用域问题:
### LHS(Left-Hand Side)查询
```javascript
let x = 10 // LHS:为变量赋值
x = 20 // LHS:修改变量值
```
LHS查询关注的是**变量的存储位置**。
### RHS(Right-Hand Side)查询
```javascript
console.log(x) // RHS:读取变量值
const y = x + 5 // RHS:读取x的值
```
RHS查询关注的是**变量的值**。
## 闭包与词法作用域
闭包是词法作用域的直接应用:
```javascript
function createCounter() {
let count = 0 // 词法作用域内的变量
return function () {
count++ // 闭包记住了count变量
return count
}
}
const counter = createCounter()
console.log(counter()) // 1
console.log(counter()) // 2
console.log(counter()) // 3
```
:::important 闭包的本质
闭包就是函数能够记住并访问其词法作用域,即使函数在其词法作用域之外执行。
:::
## 实际应用场景
### 1. 数据封装
```javascript
function createUser(name) {
let privateData = {
loginCount: 0,
lastLogin: null
}
return {
getName: () => name,
login: () => {
privateData.loginCount++
privateData.lastLogin = new Date()
console.log(`${name} 登录成功`)
},
getStats: () => ({ ...privateData })
}
}
const user = createUser('张三')
user.login()
console.log(user.getStats())
```
### 2. 模块模式
```javascript
const MyModule = (function () {
let privateVar = '私有变量'
function privateMethod() {
console.log('私有方法')
}
return {
publicMethod() {
privateMethod()
return privateVar
}
}
})()
console.log(MyModule.publicMethod())
```
### 3. 事件处理
```javascript
function setupButtons() {
const buttons = document.querySelectorAll('.btn')
for (let i = 0; i < buttons.length; i++) {
buttons[i].addEventListener('click', () => {
console.log(`按钮 ${i} 被点击`)
})
}
}
```
## 常见陷阱与最佳实践
### 陷阱1:循环中的闭包
```javascript
// ❌ 错误写法
// eslint-disable-next-line vars-on-top, no-var
for (var i = 0; i < 3; i++) {
setTimeout(() => {
console.log(i) // 总是输出 3
}, 100)
}
// ✅ 正确写法
for (let i = 0; i < 3; i++) {
setTimeout(() => {
console.log(i) // 输出 0, 1, 2
}, 100)
}
```
### 陷阱2:内存泄漏
```javascript
// ❌ 可能造成内存泄漏
function createHeavyClosure() {
const largeData = Array.from({ length: 1000000 }).fill('data')
return function () {
// 即使不需要largeData,它仍然被保留在内存中
console.log('操作完成')
}
}
// ✅ 及时释放引用
function createOptimizedClosure() {
let largeData = Array.from({ length: 1000000 }).fill('data')
const result = function () {
console.log('操作完成')
}
// 使用完后释放大对象
largeData = null
return result
}
```
## 调试技巧
:::tip 调试作用域问题
* 使用浏览器开发者工具的Scope面板
* 添加console.log检查变量状态
* 使用debugger语句设置断点
:::
```javascript
function debugScope() {
const localVar = '局部变量'
debugger // 在这里暂停,查看作用域
console.log(localVar)
}
debugScope()
```
## 总结
词法作用域是JavaScript的基础支柱,它:
* ✅ **在代码书写时确定**作用域关系
* ✅ **支持作用域链**的变量查找机制
* ✅ **实现闭包**功能,允许函数"记住"其创建时的环境
* ✅ **促进模块化**和代码封装
掌握词法作用域不仅有助于理解JavaScript的运行机制,更能帮助你在实际开发中写出更安全、更高效的代码。
记住:**作用域在书写时确定,闭包让作用域"活"得更久**。
\==深入学习建议=={.tip}
* 阅读ECMAScript规范中的作用域相关章节
* 实践闭包在各种场景下的应用
* 学习函数式编程中的相关概念
---
---
url: /article/fybr4lt3/index.md
---
# Webpack场景下的项目优化方案
::: center
{width=100}
:::
在一个基于 webpack 作为构建工具的前端项目中,通常会有以下两个方面进行优化。
1. [编译构建时间优化](#编译构建时间优化)
2. [构建产物优化](#构建产物优化)
## 编译构建时间优化
编译构建时间优化,旨在加快每次构建的速度,减少构建时间。
它包括,开发时每次修改文件重新编译时的时间开销;为项目构建最终产物时的总体时间开销。
优化的方向包括:
1. [编译构建时间优化](#编译构建时间优化).
2. [缩小文件匹配范围](#缩小文件匹配范围).
3. [文件后缀匹配](#文件后缀匹配).
4. [缓存](#缓存).
5. [并行构建](#并行构建).
### 缩小文件匹配范围
在配置 webpack loader 时,通常会指定两个属性:`test` 和 `use` ,用以声明哪些文件需要被转换。
```js
module.exports = {
module: {
rules: [{ test: /\.txt$/, use: 'raw-loader' }],
},
}
```
在默认情况下,匹配查找范围是相对于项目根目录的上下文进行搜索,当项目文件数量很多时,这个过程会非常耗时。
在这种情况下,可以使用 `include` 和 `exclude` 两个属性来限制文件匹配范围。
```js
const path = require('node:path')
module.exports = {
module: {
rules: [
{
test: /\.txt$/,
use: 'raw-loader',
include: path.resolve(__dirname, 'src'),
exclude: /node_modules/,
},
],
},
}
```
* `exclude` : 排除所有符合条件的文件
* `include` : 只包含所有符合条件的文件
合理的使用 `include` 和 `exclude` 属性可以有效的减少文件匹配范围,从而减少构建时间。
> **参考:** [webpack module.rules](https://www.webpackjs.com/configuration/module/#rule)
### 文件后缀匹配
通常我们在导入模块时,习惯忽略文件后缀名,因为 `webpack` 会帮助进行补全。
但这是有代价的,webpack 内部尝试使用内置配置,补全后缀后查找文件时候存在,再尝试加载,直到匹配到文件,
这会造成额外的 I/O 开销。
一方面,可以通过修改 webpack 的配置 `resolve.extensions`,调整 后缀补全的规则,并通过顺序控制补全的优先级,
将最常用的文件后缀放在最前面,并减少非必要的后缀名。
```js
module.exports = {
resolve: {
// .md, .json 等非必要的,则不要写入配置
extensions: ['.tsx', '.ts', '.js'],
},
}
```
另一方面,在导入模块时,尽量不要忽略文件后缀名。
> **参考**: [webpack resolve.extensions](https://www.webpackjs.com/configuration/resolve/#resolveextensions)
### 缓存
每次启动构建,如果都需要重新编译所有的文件,那么势必会花费很长的时间,
所以需要对编译结果进行缓存,以便下次直接加载缓存的结果,并只对修改的文件进行重新编译。
在 `webpack5` 中,提供了 `cache` 配置,可直接开启缓存。
```js
module.exports = {
cache: {
type: 'filesystem',
},
}
```
> **参考**: [webpack cache](https://www.webpackjs.com/configuration/cache/#cache)
### 并行构建
webpack 运行在 NodeJS 环境中,是单线程的,所以一次只能干一件事。
而目前主流的电脑都是多核的,可以利用这一特性,让 webpack 并行构建。
通常情况下,使用 [thread-loader](https://github.com/webpack-contrib/thread-loader) 来实现并行构建。
```js
module.exports = {
module: {
rules: [
{
test: /.jsx?$/,
use: [
// 开启多进程打包。
{
loader: 'thread-loader',
options: {
workers: 3, // 开启 3个 进程
},
},
{ loader: 'babel-loader' },
],
},
],
},
}
```
放置在 thread-loader 之后的 loader 会在一个单独的 worker 池(worker pool) 中运行。
每个 worker 都是一个单独的有 600ms 限制的 node.js 进程。同时跨进程的数据交换也会被限制。所以建议仅在耗时的 loader 上使用。
如果项目不大,文件不多,则没必要使用 thread-loader。其本身也有额外的性能开销。
## 构建产物优化
构建产物优化,旨在 减少构建产物的体积,合理的组织构建产物,从而提高页面的加载速度,首屏加载速度等。
通用的构建优化包括:
1. [压缩 `js`, `css`,`html` 代码](#压缩-js-csshtml-代码).
2. [压缩图片资源](#压缩图片资源).
3. [代码分割](#代码分割).
4. [按需加载](#按需加载).
5. [preload, prefetch](#preload-prefetch).
6. [tree-shaking](#tree-shaking).
### 压缩 js, css,html 代码
#### 压缩 js
使用 `terser-webpack-plugin` 来压缩 js 代码:
```js
const TerserPlugin = require('terser-webpack-plugin')
module.exports = {
optimization: {
minimize: true,
minimizer: [new TerserPlugin()],
},
}
```
#### 压缩 css
通过 `css-minimizer-webpack-plugin` 来压缩 css 代码,
同时使用 `mini-css-extract-plugin` 将 css 提取到单独的文件中。
```js
const CssMinimizerPlugin = require('css-minimizer-webpack-plugin')
const MiniCssExtractPlugin = require('mini-css-extract-plugin')
module.exports = {
module: {
rules: [
{
test: /\.css$/,
use: [
// 提取成单独的文件
MiniCssExtractPlugin.loader,
'css-loader',
],
},
],
},
plugins: [
new MiniCssExtractPlugin({
// 定义输出文件名和目录
filename: 'asset/css/style.css',
}),
],
optimization: {
minimize: true,
minimizer: [
// 压缩 css
new CssMinimizerPlugin({}),
],
},
}
```
#### 压缩 html
使用 `html-webpack-plugin` 来压缩 html 代码。
```js
const HtmlWebpackPlugin = require('html-webpack-plugin')
module.exports = {
plugins: [
new HtmlWebpackPlugin({
// 动态生成 html 文件
template: './index.html',
minify: {
// 压缩HTML
removeComments: true, // 移除HTML中的注释
collapseWhitespace: true, // 删除空⽩符与换⾏符
minifyCSS: true, // 压缩内联css
},
}),
],
}
```
### 压缩图片资源
压缩 图片资源的方法多种多样,需要根据实际的情况进行选择。
其中还包括多倍图的处理,如:`@2x`、`@3x`、`@4x` 等。
比如,可以使用 `image-webpack-loader` 来实现图片压缩。
```js
module.exports = {
module: {
rules: [
{
test: /\.(png|jpg|gif|jpeg|webp|svg)$/,
use: [
'file-loader',
{
loader: 'image-webpack-loader',
options: {
mozjpeg: { progressive: true },
optipng: { enabled: false },
pngquant: { quality: [0.65, 0.9], speed: 4 },
gifsicle: { interlaced: false },
},
},
],
exclude: /node_modules/,
},
],
},
}
```
### 代码分割
如果是一个 中大型项目,或者是一个 MPA 项目,一般会拥有多个页面,
但都是使用的相同的技术栈,有重复使用的公共资源。
如果每个页面的代码都独自包含这些相同的代码,则会导致资源的浪费,每次加载不同页面都会加载重复的资源,
浪费用户的流量,页面加载缓慢,影响用户体验。
在这种情况下,将第三方的模块、公共资源单独拆分为独立的文件,
利用缓存机制,不同页面加载的时候只需要花费首次加载的时间,减少二次加载等待时间。
```js
module.exports = {
// ...
optimization: {
splitChunks: {
chunks: 'async', // 值有 `all`,`async` 和 `initial`
minSize: 20000, // 生成 chunk 的最小体积(以 bytes 为单位)。
minRemainingSize: 0,
minChunks: 1, // 拆分前必须共享模块的最小 chunks 数。
maxAsyncRequests: 30, // 按需加载时的最大并行请求数。
maxInitialRequests: 30, // 入口点的最大并行请求数。
enforceSizeThreshold: 50000,
cacheGroups: {
defaultVendors: {
test: /[\/]node_modules[\/]/, // 第三方模块拆出来
priority: -10,
reuseExistingChunk: true,
},
utilVendors: {
test: /[\/]utils[\/]/, // 公共模块拆出来
minChunks: 2,
priority: -20,
reuseExistingChunk: true,
},
},
},
},
}
```
> **参考**: [代码分离](https://www.webpackjs.com/guides/code-splitting)
### 按需加载
大多数时候,使页面达到可用,并不需要加载所有的资源。
比如在 SPA/MPA 应用中,通过路由来实现不同的页面,如果所有的页面代码都打包在相同的文件,
那么加载某个页面的代码时,实际上也加载了其它页面的代码,导致页面的加载速度达不到预期。
因为,将 路由页面的资源拆分为不同的文件,使用时才加载这些资源,可以减少当前页面的加载时间。
```js
const List = lazyComponent('list', () => import(/* webpackChunkName: "list" */ '@/pages/list'))
const Detail = lazyComponent('detail', () => import(/* webpackChunkName: "detail" */ '@/pages/detail'))
```
进一步的,越尽快的让页面渲染,就越有利于用户体验。
因此,还可以分析当前页面完成首屏渲染所需要的关键资源,将非关键资源拆分出去,首次只加载
关键资源,完成后再加载非关键资源。
### preload, prefetch
* refetch(预获取):将来某些导航下可能需要的资源
* preload(预加载):当前导航下可能需要资源
在webpack中使用 `prefetch` 实现预获取:
```js
// ...
import(/* webpackPrefetch: true */ './path/to/LoginModal.js')
```
这会生成 `
` 并追加到页面头部,指示浏览器在闲置时间预取 login-modal-chunk.js 文件。
在webpack中使用 `preload` 实现预加载:
```ts
// ...
import(/* webpackPreload: true */ 'ChartingLibrary')
```
在页面中使用 `ChartComponent` 时,在请求 `ChartComponent.js` 的同时,
还会通过 `
` 请求 `charting-library-chunk`。
假定 `page-chunk` 体积比 `charting-library-chunk` 更小,也更快地被加载完成,
页面此时就会显示 `LoadingIndicator` ,等到 `charting-library-chunk` 请求完成,
`LoadingIndicator` 组件才消失。这将会使得加载时间能够更短一点,因为只进行单次往返,
而不是两次往返,尤其是在高延迟环境下。
> **参考**: [webpack prefetch/preload](https://www.webpackjs.com/guides/code-splitting#prefetchingpreloading-modules)
### tree-shaking
`tree shaking` 在**生产模式下已经默认开启**
需要注意的是:
* 只对ESM生效
* 只能是静态声明和引用的 ES6 模块,不能是动态引入和声明的。
* 只能处理模块级别,不能处理函数级别的冗余。
* 只能处理 JS 相关冗余代码,不能处理 CSS 冗余代码。
对于 CSS资源, 可以使用 `purgecss-webpack-plugin` 插件对 CSS 进行 tree-shaking。
```js
const PurgecssPlugin = require('purgecss-webpack-plugin')
module.exports = {
plugins: [
new PurgeCSSPlugin({
paths: glob.sync('src/**/*', { nodir: true }),
}),
],
}
```
> **参考**: [webpack tree-shaking](https://www.webpackjs.com/guides/tree-shaking/)
---
---
url: /article/g8wq3mzt/index.md
---
# JavaScript 正则表达式完全指南
本文是对 2018 年那篇 [《正则表达式使用手册》](/article/e8qbp0dh/) 的重写,结合 2026 年的现状做了全面更新。
这些年 JavaScript 正则表达式发生了不小的变化:`ES2018` 带来了命名捕获组、后行断言、Unicode 属性转义和 `s` 标志;`ES2022` 增加了 `d` 标志;`ES2024` 增加了 `v` 标志;`ES2025` 又补上了 `RegExp.escape()`、内联修饰符和重复命名捕获组。
本文基于 `ECMAScript 2025` 规范与当前主流运行时(Node.js 24 LTS、Chrome/Edge、Safari、Firefox 的最新版本)编写,目标是:**准确、完整、可用于 2026 年的工程实践**。
:::warning 语言范围
正则表达式的方言差异极大。本文只讨论 **JavaScript(ECMAScript)** 的 `RegExp`,不要想当然地套用到 Python、PCRE、Go 或 Rust —— 它们的转义规则、锚点语义、Unicode 行为都不完全相同。文中会标注若干易混淆的差异点。
:::
## 一、正则表达式是什么
`正则表达式`(Regular Expression)是一种**描述文本模式**的形式化语言,用来在字符串中查找、校验、提取或替换符合规则的子串。
一个最小例子:
```js
const text = `name:Mark tel:13800138000
name:Jhon tel:13800138888`
const result = text.match(/tel:(1\d{10})/)
// ["tel:13800138000", "13800138000", index: 0, ...]
console.log(result[1]) // 13800138000
```
`/tel:(1\d{10})/` 就是正则表达式,其中 `()` 表示「捕获」匹配到的内容,`\d` 表示数字,`{10}` 表示重复 10 次。
但需要先明确一点:**JavaScript 的 `RegExp` 是回溯(backtracking)引擎**。它功能强、语法丰富(支持反向引用、任意断言),代价是最坏情况下可能产生指数级的时间复杂度(见第十节)。
## 二、创建正则的两种方式
### 2.1 字面量与构造函数
```js
// 1. 字面量
const re1 = /\d+/g
// 2. 构造函数
const re2 = new RegExp('\\d+', 'g')
```
二者生成的正则对象**语义完全一致**,`re1.source === re2.source`、`re1.flags === re2.flags`。区别在于:
| 维度 | 字面量 `/\d+/g` | 构造函数 `new RegExp()` |
| ------------ | ------------------------------ | -------------------------- |
| 适用场景 | 模式静态、写在代码里 | 模式需要动态拼接 |
| 转义成本 | 低,所见即所得 | 高,反斜杠要写两遍 |
| 语法错误时机 | **解析期**报错,构建时就能发现 | **运行期**抛 `SyntaxError` |
```js
// 构造函数需要双重转义,容易写错
const re = new RegExp('\\d{4}-\\d{2}')
// 推荐写法:用 String.raw 避免双重转义
const re2 = new RegExp(String.raw`\d{4}-\d{2}`)
```
### 2.2 一个常见的误解
一个流传很广的说法是「正则字面量在编译期就完成了,性能更好」。这需要澄清:
* 从 `ES5` 开始,**正则字面量每次求值都会创建一个新的 `RegExp` 对象**,并不存在「只编译一次」的对象复用:
```js
function make() {
return /a/
}
console.log(make() === make()) // false,两个不同的对象
```
* 引擎确实会缓存**编译后的模式**,所以重复使用字面量的匹配开销很低;但如果你需要**跨调用累积 `lastIndex`**(典型场景是 `exec` 循环遍历),就必须复用同一个对象,应该把它提取成模块级常量:
```js
// 推荐:模块顶层只创建一次
const RE_DATE = /\d{4}-\d{2}-\d{2}/g
RE_DATE.exec('2026-09-10 与 2025-01-01')[0] // '2026-09-10'
RE_DATE.exec('2026-09-10 与 2025-01-01')[0] // '2025-01-01',靠 lastIndex 递增
```
### 2.3 动态构造用户输入:`RegExp.escape()`
如果你把用户输入拼进正则,**必须转义**,否则用户输入里的 `.`、`*`、`(` 会改变模式语义,甚至直接抛 `SyntaxError`:
```js
// ❌ 危险:输入 "1+1" 会变成非法正则
const keyword = searchInput // 来自用户
new RegExp(keyword)
// ✅ ES2025:安全地把任意字符串转成字面量模式
new RegExp(RegExp.escape(keyword), 'g')
```
`RegExp.escape()` 已进入 `ES2025`,是 Baseline 2025 特性。
它比手写的 `replace(/[.*+?^${}()|[\]\\]/g, '\\$&')` 更可靠:手写版本必须同时兼容 `u` 与 `v` 两套转义规则,
很容易漏 —— 例如 `RegExp.escape('a-b')` 返回的是 `'\\x61\\x2db'`,连 `a` 都被转成了 `\x61`,
正是为了避免 `-` 与相邻字符被解析成范围。**不要自己造轮子。**
## 三、元字符速查表
正则表达式由`元字符`与普通字符组成。元字符需要按特殊含义解释,普通字符按字面匹配。
| 字符 | 含义 |
| :-------: | ------------------------------------------------------------------------------------------------------------------------------------- |
| `\` | 转义符。`\d` 表示「数字」而非字母 `d`;`\.` 表示「普通的点字符」。 |
| `^` | 匹配**输入的开头**(开启 `m` 时为每行开头)。 |
| `$` | 匹配**输入的结尾**(开启 `m` 时为每行结尾)。⚠️ 与 Python/Perl 不同,JS 不加 `m` 时 **不会**在末尾换行符之前匹配。 |
| `*` | 前一个**原子**重复 0 次或多次。 |
| `+` | 前一个原子重复 1 次或多次。 |
| `?` | 前一个原子重复 0 次或 1 次;跟在量词之后时表示「懒惰」(见第五节)。 |
| `.` | 匹配除**行终止符**外的任意字符。行终止符不止 `\n`:还包括 `\r`、`\u2028`(行分隔符)、`\u2029`(段分隔符)。加 `s` 后可匹配所有字符。 |
| `x\|y` | 分支:匹配 `x` 或 `y`。 |
| `[xyz]` | 字符类,匹配集合中任意一个字符。可用 `-` 指定范围。 |
| `[^xyz]` | 反向字符类,匹配**不在**集合中的任意一个字符。 |
| `{n}` | 前一个原子恰好重复 n 次。 |
| `{m,n}` | 前一个原子重复 m 到 n 次(尽量多)。`{m,}` 表示至少 m 次。⚠️ JS **不支持** `{,n}` 简写(见 5.4)。 |
| `(x)` | 捕获分组,匹配并保存 `x`,同时分配一个编号(从 1 开始)。 |
| `(?:x)` | 非捕获分组,只分组不保存。 |
| `(?
x)` | 命名捕获分组,保存为 `groups.n`。 |
| `x(?=y)` | 正向前瞻:`x` 后面必须是 `y`,但 `y` 不消耗。 |
| `x(?!y)` | 负向前瞻:`x` 后面不能是 `y`。 |
| `(?<=y)x` | 正向后行断言:`x` 前面必须是 `y`。 |
| `(?` | 反向引用,匹配命名捕获组 `n` 的内容。 |
| `\p{...}` | Unicode 属性转义(**需要 `u` 或 `v` 标志**),匹配属于该属性的字符。 |
| `\P{...}` | Unicode 属性转义的反集。 |
### 3.1 字符类内的转义规则
在 `[...]` 内部,元字符的「特殊身份」会发生变化:
| 字符 | 在 `[]` 内是否需要转义 | 说明 |
| --------------- | -------------------------- | ------------------------------------------ |
| `-` | **需要**(作为普通字符时) | 否则会被当成范围,如 `[a-z]` |
| `]` `\` `^` | **需要** | `^` 仅在第一个位置特殊,其余位置是普通字符 |
| `.` `*` `+` `?` | 不需要 | 在 `[]` 内失去特殊含义,写不写 `\` 都行 |
:::tip `v` 模式下更严格
上表适用于非 `v` 模式。开启 `v` 标志后,字符类内的保留字符更多:`( ) [ ] { } / - \ |` 都必须转义,`&&`、`~~` 这类「双标点」也被保留给集合运算。所以 `/[()]/u` 合法,而 `/[()]/v` 会直接抛 `SyntaxError`。
:::
```js
// 匹配连字符、右括号和反斜杠本身
const re = /[\]\\-]/
```
### 3.2 关于 `\s` 的一个过时细节
很多资料会把 `\u180e`(蒙古文元音分隔符)算进 `\s`。**这是过时的**:自 Unicode 6.3 起 `U+180E` 已被重新归类为非空白字符,规范中的 `\s` 集合也已将它移除。可以用 `/\s/.test('\u180e')` 验证,结果为 `false`。
## 四、Unicode:JS 正则最容易踩坑的地方
### 4.1 `\d`、`\w` 永远只匹配 ASCII
这是 JavaScript 与其他语言(如 Python 的 `re` 带 `UNICODE` 模式、.NET)最显著的差异之一:
```js
/\d/.test('٣') // false —— 阿拉伯-印度数字 3
/\d/.test('3') // false —— 全角数字 3
/\d/u.test('٣') // false —— 加了 u 也一样!
/\w/.test('中') // false —— 汉字不算「单字字符」
```
`u` 标志**只改变解析规则与码点处理方式,不改变 `\d`/`\w` 的字符集合**。要匹配 Unicode 语义下的「数字」「字母」,必须用属性转义:
```js
/\p{Decimal_Number}/u.test('٣') // true
/\p{Letter}/u.test('中') // true
/^\p{Letter}\p{Mark}*$/u.test('e\u0301') // true —— 字母 + 组合音标
```
### 4.2 `u` 标志
`u`(unicode)标志的主要作用:
1. 按**码点**而非 UTF-16 码元解析模式,正确处理 `😀` 这类由代理对组成的字符;
2. 启用 `\u{...}` 码点转义与 `\p{...}` 属性转义;
3. 让正则**严格化**:非法转义、孤立的量词会直接抛 `SyntaxError`,而不是被当作字面量。这是好事,能提前暴露错误。
```js
/^.$/.test('😀') // false,. 只吃掉一个码元
/^.$/u.test('😀') // true,u 模式下 . 匹配一个码点
/^\u{1F600}$/u.test('😀') // true
```
### 4.3 `v` 标志(ES2024):Unicode 集合运算
`v`(unicodeSets)是 `u` 的**超集**,二者**互斥**(`new RegExp('a', 'uv')` 会抛 `SyntaxError`)。它带来三样东西:
```js
// 1. 集合运算:交集 &&、差集 --
/[\p{Letter}--[a-z]]/v.test('中') // true,是非 ASCII 的字母
/[\p{Letter}--[a-z]]/v.test('a') // false
/[\p{Script=Greek}&&\p{Letter}]/v.test('α') // true
// 2. 嵌套字符类
/[[a-z]--[aeiou]]/v.test('b') // true
// 3. 字符类中的字符串字面量与「字符串属性」
/[\q{ab|c}]/v.test('ab') // true,\q{} 里是字符串候选
/^\p{RGI_Emoji}$/v.test('😀') // true,属性可以是「字符串集合」而非单字符
```
在 `v` 模式下,字符类的转义规则比 `u` 更严格(见 3.1 的说明),升级时要注意兼容性。
:::info 该用 `u` 还是 `v`?
`v` 是 `u` 的超集,但**不能**用它来「顺便兼容」:`v` 模式下部分在 `u` 下合法的模式会报错。策略上:只用 `u` 即可满足需求时优先 `u`(兼容面更广);确实需要集合运算或字符串属性时再用 `v`。目标运行时较老(如需支持 2022 年前的浏览器)时,可用 `Regex+`、`regexpu` 之类的工具降级编译。
:::
## 五、量词、贪婪与懒惰
### 5.1 量词作用于「前一个原子」
量词 `* + ? {n,m}` 只作用于它**前面紧邻的那一个原子**(一个字符、一个字符类、一个分组或一个断言):
```js
/ab*/.exec('abbbbbc')[0] // 'abbbbb',* 只作用于 b
/(ab)*/.exec('ababab')[0] // 'ababab',* 作用于整个分组
```
### 5.2 `?` 的两种身份
`?` 有两种完全不同的含义,取决于它出现的位置:
1. **作为量词**:跟在原子后面,表示重复 0 或 1 次 —— `ab?` 可匹配 `a` 或 `ab`;
2. **作为懒惰后缀**:跟在另一个量词(`*`、`+`、`?`、`{m,n}`)后面,把该量词从贪婪改为懒惰 —— `ab??`、`a*?`。
### 5.3 贪婪 vs 懒惰
默认是**贪婪**的:在能满足整体匹配的前提下,尽可能多地匹配。
```js
const greedy = /.*<\/div>/
const lazy = /
.*?<\/div>/
const str = '
aaa
bbb
ccc'
str.match(greedy)[0] // '
aaa
bbb
'
str.match(lazy)[0] // '
aaa
'
```
懒惰量词的语义归纳:
| 写法 | 最少匹配 | 最多匹配 |
| --------- | -------- | -------- |
| `x*?` | 0 个 | 不限 |
| `x+?` | 1 个 | 不限 |
| `x??` | 0 个 | 1 个 |
| `x{m,n}?` | m 个 | n 个 |
但要注意:**懒惰只影响「优先尝试多少」,不改变匹配能力**。如果整体匹配要求「必须多」,懒惰量词仍会退让到多:
```js
// 懒惰不会改变「能否匹配」,只改变「优先尝试多短」
'aaab'.match(/a+?b/)[0] // 'aaab' —— a+? 必须扩展到 3 个 a,整体才能匹配
'
aaa
'.match(/
.*?<\/div>/)[0] // '
aaa
' —— 这里「最短」即可成功,所以只吃到第一个
```
### 5.4 注意:`{,n}` 不是合法量词
`{,1}` 常被误认为表示「0 次到 1 次」,**这在 JavaScript 中是错误的**。ECMAScript 只定义了三种量词形式:`{n}`、`{n,}`、`{n,m}`,没有 `{,m}`。
```js
/a{,1}/.test('a') // false
/a{,1}/.test('a{,1}') // true —— {,1} 被当成了字面量字符
// 只有在 u / v 模式下,{,1} 才会因为「不完整的量词」直接抛错
new RegExp('a{,1}', 'u') // SyntaxError: Incomplete quantifier
```
另外,`{m,n}` 中若 `m > n` 会直接抛错:
```js
new RegExp('a{2,1}') // SyntaxError: numbers out of order in {} quantifier
```
### 5.5 原子组与占有量词在原生 JS 中不存在
`(?>...)`(原子组)与 `a++`、`a*+`(占有量词)能有效防止回溯爆炸,但**原生 JavaScript 至今没有实现**(截至 2026 年仍未进入标准)。PCRE / Java / .NET 用户迁移到 JS 时,需要改用断言或重构模式,或使用 `Regex+` 库以编译期展开的方式模拟。
## 六、断言(零宽匹配)
断言只检验「某个位置附近的条件」,**不消耗字符**,因此不计入匹配结果,也不会推进匹配位置。
```js
// 前瞻
/\d+(?=元)/.exec('价格 100元') // ['100'],只匹配数字,'元' 被断言但未消耗
/(?<=\$)\d+/.exec('价格 $100') // ['100'],后行断言
// 否定
/\d+(?!元)/.exec('价格 100块') // ['100']
/(?\d{4})-(?
\d{2})-(?\d{2})/
const m = '2026-09-10'.match(re)
m.groups.year // '2026'
m.groups.month // '09'
// 反向引用
/(?\w+)\s+\k/.exec('hello hello')[0] // 'hello hello'
// 替换
'2026-09-10'.replace(re, '$/$/$') // '10/09/2026'
```
### 7.3 重复命名分组(ES2025)
同一模式的不同分支(`|`)中允许复用同一个组名,规范会保证同一时刻只有其中一个分支参与匹配:
```js
// ⚠️ 分支顺序仍然重要:若把 \d+ 写在前面,'2026-09-10' 会先被匹配成 '2026'
const re = /(?